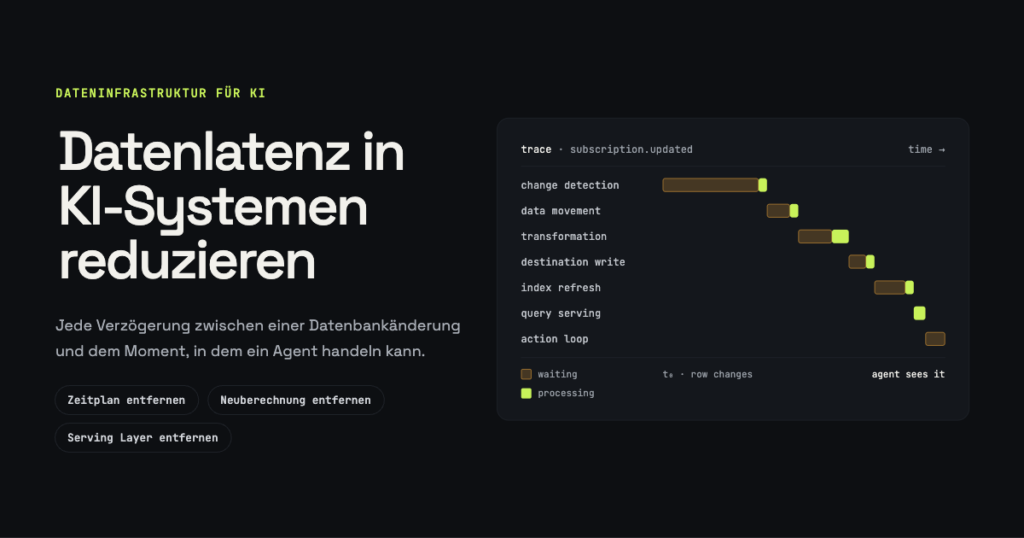
Ein KI-System erlebt Datenlatenz nicht als eine einzige Zahl, sondern als Kette von Verzögerungen. Ein Kunde ändert sein Abo in einer Produktionsdatenbank. Die Änderung muss erkannt werden. Sie muss eine Pipeline durchlaufen. Vielleicht muss sie mit anderen Informationen verknüpft oder in ein nützliches Geschäftsobjekt umgewandelt werden. Das Ergebnis muss dann womöglich in ein Data Warehouse, einen Feature Store, einen Vektorindex, eine analytische Datenbank oder eine Kontextschicht für Agenten gelangen. Schließlich muss die KI-Anwendung es abrufen.
Wo Latenz in ein KI-System gelangt
Bevor Teams Infrastruktur auswählen, sollten sie herausfinden, welcher Teil des Weges tatsächlich langsam ist.
| Latenzpunkt | Was passiert | Folge für die KI |
|---|---|---|
| Änderungserkennung | Änderungen an der Quelle warten auf den nächsten Extraktionszyklus | Die KI sieht nie den neuesten Stand |
| Datenbewegung | Erfasste Änderungen bleiben in Warteschlangen oder Mikro-Batches liegen | Der Kontext kommt zu spät |
| Transformation | Große Jobs berechnen ganze Datensätze neu | Frische Rohdaten werden zu veralteten abgeleiteten Daten |
| Schreiben ins Ziel | Warehouses oder Datenbanken erhalten Updates ineffizient | Der nachgelagerte Abruf muss warten |
| Index- oder Kontext-Refresh | Vektorspeicher und KI-Kontext werden nur periodisch aktualisiert | RAG ruft veraltete Informationen ab |
| Abfragebereitstellung | Aktuelle Daten existieren, sind aber langsam abrufbar | Die Antwortzeit des Agenten steigt |
| Aktionsschleife | Die KI wartet auf die Wirkung ihrer vorherigen Aktion | Autonome Workflows arbeiten mit einem veralteten Weltzustand |
6 Plattformen, die Datenlatenz in KI-Systemen reduzieren
1. Artie
Artie konzentriert sich auf eine der häufigsten Latenzquellen in KI-Infrastrukturen: die Zeit zwischen einer Änderung in einer transaktionalen Datenbank und ihrer Verfügbarkeit in der nachgelagerten Datenumgebung. Die Plattform nutzt logbasiertes Change Data Capture, um Inserts, Updates und Deletes laufend aus operativen Datenbanken in Ziele wie Snowflake, BigQuery, Redshift und andere Datenbanken zu replizieren. Statt immer wieder komplette Tabellen zu extrahieren oder auf geplante Batch-Jobs zu warten, liest Artie Datenbankänderungen in dem Moment, in dem sie entstehen, und überträgt sie ins Ziel. Die Plattform ist auf Replikation unter einer Minute ausgelegt, ohne dass Teams Kafka, Debezium oder eine eigene Streaming-Infrastruktur betreiben müssen. Diese Architektur ist für KI-Anwendungen nützlich, weil viele ihrer wichtigsten Fakten bereits in transaktionalen Systemen liegen. Kundenstatus, Abos, Bestellungen, Kontostände, App-Aktivität, Berechtigungen und Kontoänderungen entstehen oft in Postgres oder einer anderen OLTP-Datenbank. Gelangen diese Tabellen per Batch-Pipeline in eine analytische oder KI-fähige Umgebung, arbeitet ein Agent womöglich mit Informationen, die vor mehreren Stunden korrekt waren. Artie kümmert sich auch um die betrieblichen Begleitprobleme. Automatische Schemaentwicklung hält Pipelines am Laufen, wenn sich das Quellschema ändert, und integrierte Observability überwacht Latenz, Durchsatz, Zustand und Fehler. Historische Backfills laufen, ohne den Live-Stream anzuhalten, und der History Mode kann frühere Zustände bewahren, wenn KI- oder Analyse-Workloads mehr als die neueste Zeile brauchen. Außerdem hat die Plattform neben CDC eine Event-Ingestion ergänzt, sodass Datenbankzustand und ereignisbasierte Informationen über dieselbe Echtzeitarchitektur in nachgelagerte Systeme fließen. Für Teams, deren KI-Stack sich bereits um ein Warehouse, ein Lakehouse oder eine analytische Datenbank dreht, bietet Artie eine recht direkte Lösung für die erste und oft größte Quelle veralteter Daten: Produktionsänderungen schnell und zuverlässig aus operativen Datenbanken herauszuholen.
2. Striim
Striim verbindet Echtzeit-CDC mit Stream Processing und einer zunehmend KI-spezifischen Dateninfrastruktur. Die Plattform erfasst Änderungen aus Unternehmensdatenquellen und liefert sie laufend in Systeme wie Snowflake, BigQuery, Databricks, Redshift, ClickHouse, Microsoft Fabric und andere analytische Umgebungen. Die Architektur ist besonders relevant für Unternehmen mit komplexen operativen Datenbanken, heterogener Infrastruktur und hohem Replikationsvolumen. Für KI-Systeme geht Striim über reine Datenbewegung hinaus. Die aktuelle Plattform umfasst Komponenten, um Vektor-Embeddings direkt in Streaming-Pipelines zu erzeugen, sensible Informationen zu erkennen und zu schützen, Anomalien zu identifizieren und KI-Agenten Unternehmensdaten in Echtzeit bereitzustellen. Die Updates aus 2026 brachten außerdem MCP-basierte Funktionen, mit denen agentische Anwendungen mit stets aktuellen Unternehmensinformationen arbeiten können. Das spart einen Übergabeschritt, der sonst Latenz verursachen kann. Eine klassische RAG-Pipeline repliziert zuerst die Quelldaten und wartet dann auf einen separaten Job, der neue Datensätze erkennt, Embeddings erzeugt und sie in ein weiteres System liefert. Striim kann diese KI-bezogene Verarbeitung direkt im Datenstrom erledigen und verkürzt so die Zeit zwischen einem Geschäftsereignis und dem Moment, in dem seine semantische Darstellung nutzbar wird. Die Plattform unterstützt auch die Verarbeitung von Daten in Bewegung: Teams können Datensätze filtern, aggregieren, anreichern, maskieren oder anderweitig anpassen, bevor sie nachgelagerte KI-Systeme erreichen.
3. Fivetran HVR
Fivetran HVR ist für Replikation mit hohem Volumen und niedriger Latenz in Unternehmensumgebungen gemacht. HVR nutzt logbasiertes CDC und eine verteilte Architektur, bei der Agenten nah an Datenbanken und Transaktionslogs platziert werden können. Das senkt den Aufwand beim Erfassen großer Änderungsmengen und ist besonders relevant für Unternehmen, die operative Systeme replizieren, die keine schweren Abfragen an der Quelle vertragen. Für die KI-Infrastruktur wird HVR interessant, wenn die aktuell zu haltenden Daten in großen, etablierten Transaktionssystemen liegen. Viele KI-Initiativen in Unternehmen stoßen früher oder später auf Oracle, SQL Server, SAP-nahe Umgebungen, On-Premises-Datenbanken oder andere Systeme, die nie für Echtzeit-KI gedacht waren. Diese Quellen zu ersetzen ist selten realistisch. KI-Teams brauchen stattdessen einen verlässlichen Weg, sich ständig ändernde operative Daten in Cloud-Plattformen zu bringen, wo Modelle und Agenten sie nutzen können. HVR unterstützt einen kontinuierlichen Integrationsmodus für Fälle, die minimale Replikationslatenz erfordern, und kann die Latenz getrennt bei Erfassung und Zielintegration überwachen. Teams können Latenz-SLAs festlegen und Warnungen auslösen, wenn die Replikation die erwarteten Grenzwerte überschreitet. Wenn ein Agent von einer angeblich aktuellen Kundentabelle abhängt, muss das Datenteam wissen, ob „aktuell“ zwei Sekunden hinter der Quelle bedeutet oder 20 Minuten, weil ein Replikationsprozess hängt.
4. Streamkap
Streamkap basiert auf verwaltetem CDC und Stream Processing, mit Datenbewegung unter einer Sekunde als zentralem Designziel. Die Plattform erfasst Datenbankänderungen per logbasiertem CDC und liefert sie laufend in Warehouses, Lakehouses, Datenbanken, Kafka und anwendungsnahe Ziele. Unterstützt werden Quellen wie Postgres, MySQL, MongoDB, SQL Server und Oracle, und Transformationen können laufen, während die Daten unterwegs sind. In einer klassischen Architektur werden Daten zwar schnell erfasst, warten dann aber auf einen separaten Transformationsjob, bevor eine Anwendung sie nutzen kann. Mit Streamkap lassen sich Datensätze mit SQL, Python oder JavaScript direkt im Datenstrom transformieren, verknüpfen, filtern, anreichern, routen oder maskieren. Das Unternehmen nennt eine P99-Latenz von der Quelle bis zum Ziel unter 250 Millisekunden für seine verwalteten Pipelines, und die aktuelle agentenorientierte Architektur ist darauf ausgelegt, externen KI-Systemen live verarbeitete Streams bereitzustellen. Streamkap hat außerdem Streaming Agents eingeführt, derzeit in der Beta, die LLM-gestützte Verarbeitung direkt auf Kafka-Streams ausführen. Ein Agent kann Datensätze konsumieren, mit einem Modell und optionalen Tools klassifizieren, anreichern, schwärzen oder zusammenfassen, das Ergebnis prüfen und es zurück in einen Stream schreiben.
5. RisingWave
RisingWave setzt nach der Datenerfassung an, indem es laufend genau den Zustand pflegt, den Anwendungen und KI-Systeme tatsächlich brauchen. Es ist eine PostgreSQL-kompatible Streaming-Datenbank, die Streams und CDC-Daten aufnimmt, kontinuierliche SQL-Transformationen ausführt und Materialized Views aktualisiert, sobald neue Informationen eintreffen. RisingWave nennt eine End-to-End-Latenz unter 100 Millisekunden für Streaming-Workloads. Dieses Modell kann eine der am meisten übersehenen Verzögerungen in KI-Architekturen beseitigen: die Neuberechnung. Angenommen, ein KI-System braucht einen Kundenrisikowert aus aktuellen Transaktionen, Kontodaten, historischer Aktivität und jüngsten Warnungen. Alle vier Quellen in Echtzeit zu erfassen garantiert noch kein frisches Ergebnis, wenn die verknüpfte Risikotabelle nur alle 30 Minuten neu aufgebaut wird. In einer inkrementellen Architektur ändert sich das abgeleitete Ergebnis selbst, sobald sich seine Eingaben ändern. RisingWave aktualisiert Materialized Views laufend, statt die gesamte Abfrage immer wieder neu auszuführen. Diese Views sind über Standard-PostgreSQL-Schnittstellen abrufbar, sodass der aktuelle Geschäftszustand direkt für Anwendungen und Agenten-Frameworks bereitsteht. RisingWave 3.0 hat diese Richtung hin zu agentischer KI ausgebaut, mit nativer pgvector-Ingestion, WebSocket- und HTTP-Konnektoren, Exactly-once-Zustellung und tieferer Apache-Iceberg-Unterstützung.
6. Tinybird
Tinybird widmet sich einem weiteren Teil der Latenzkette: schnell eintreffende Daten in Informationen zu verwandeln, die eine Anwendung oder ein KI-Agent sofort abfragen kann. Die Plattform kombiniert verwaltete ClickHouse-Infrastruktur mit Streaming-Ingestion, SQL-Transformationen, Materialized Views, API-Endpunkten und MCP-Zugang für KI-Agenten. Daten können über HTTP, Kafka, Cloud-Speicher, Datenbankintegrationen und weitere Wege eingespeist werden, und Ergebnisse für Anwendungen lassen sich als APIs mit niedriger Latenz bereitstellen. Das ist wichtig, weil frische Daten wenig nützen, wenn ihre Bereitstellung eine langsame analytische Abfrage erfordert. KI-Systeme brauchen zur Inferenzzeit oft vordefinierten Kontext: die letzte Aktivität eines Kontos, aggregierte Kennzahlen zu einem Produkt, aktuelle Betriebsstatistiken oder jüngste Ereignisse, die bestimmte Kriterien erfüllen. Mit Tinybird definieren Teams Transformationen in SQL und veröffentlichen das Ergebnis als API-Endpunkt, statt ein separates Backend rund um den analytischen Speicher zu bauen. Die Plattform nennt Abfragelatenzen unter einer Sekunde für analytische Workloads mit hohem Volumen, und Materialized Views in Echtzeit können häufig angefragte Ergebnisse laufend vorbereiten.
Drei verschiedene Wege, Wartezeiten zu beseitigen
Plattformen in dieser Kategorie senken die Latenz über drei grundlegend verschiedene Mechanismen.
Den Zeitplan abschaffen
CDC-Plattformen beseitigen die Verzögerung, die durch das Warten auf den nächsten Extraktionsjob entsteht. Statt alle 15 Minuten nachzusehen, ob sich etwas geändert hat, verarbeiten sie Änderungen fortlaufend. Das ist meist die größte Verbesserung, wenn eine Organisation sich von klassischem Batch-ELT verabschiedet.
Die Neuberechnung abschaffen
Streaming-Datenbanken und inkrementelle Transformationssysteme machen es überflüssig, einen ganzen Datensatz neu aufzubauen, wenn sich nur ein kleiner Teil geändert hat. Ändert eine Transaktion den aktuellen Kontostand eines Kunden, aktualisiert das System das betroffene Ergebnis, statt den gesamten historischen Datensatz neu zu verarbeiten. Das wird umso wichtiger, je ausgefeilter der abgeleitete KI-Kontext wird.
Die Bereitstellungsschicht abschaffen
Analytische Echtzeitplattformen können verarbeitete Informationen direkt über APIs oder Abfrageschnittstellen mit niedriger Latenz bereitstellen. Das erspart es, Daten noch einmal in einen Cache oder eine Anwendungsdatenbank zu verschieben, nur weil die Analyseplattform für Produktionsanfragen zu langsam ist. Die beste KI-Architektur kann alle drei Ansätze verbinden: Änderungen fortlaufend erfassen, abgeleitete Zustände inkrementell aktualisieren und das Ergebnis über eine Schnittstelle mit niedriger Latenz bereitstellen.
Latenz senken, ohne Zuverlässigkeit zu verlieren
Niedrige Latenz ist nur sinnvoll, wenn die Daten vertrauenswürdig bleiben. Aggressive Architekturen können neue Probleme schaffen, wenn Teams nur auf Geschwindigkeit optimieren. Eine Pipeline liefert Daten vielleicht schnell, dupliziert aber bei einer Wiederherstellung Ereignisse. Eine Schemaänderung entfernt womöglich unbemerkt ein Feld, das eine KI-Funktion nutzt. Ereignisse in falscher Reihenfolge können einen falschen aktuellen Zustand erzeugen. Ein fehlgeschlagener Schreibvorgang im Ziel lässt eventuell nur einen Teil einer Transaktion sichtbar. Produktive KI braucht deshalb Aktualität und Korrektheit zugleich. Wichtige Fähigkeiten sind:
- Zustellgarantien
- Schemaentwicklung
- Reihenfolge, wo nötig
- Backfills
- Replay
- Behandlung fehlgeschlagener Nachrichten
- Pipeline-Monitoring
- Datenvalidierung
- Wiederherstellung ohne Unterbrechung der Live-Verarbeitung
Ziel ist nicht, Daten um jeden Preis so schnell wie möglich zu bewegen, sondern die Zeit zu minimieren, bis ein korrekter neuer Zustand für das KI-System verfügbar ist.
Häufige Fragen
Können KI-Systeme wirklich null Datenlatenz erreichen?
Kein verteiltes Produktionssystem hat buchstäblich null Latenz. Praktisches Ziel ist es, vermeidbare Wartezeiten zu beseitigen und die Gesamtverzögerung so weit zu senken, dass sie für den Anwendungsfall unerheblich ist. Je nach Workload können das Millisekunden, Sekunden oder einige Minuten sein. Ein sinnvolles Ziel sollte sich daran orientieren, wie schnell veraltete Informationen Entscheidungen beeinflussen.
Wie senkt CDC die Datenlatenz für KI?
Change Data Capture liest Inserts, Updates und Deletes aus den Transaktionslogs der Datenbank und sendet diese Änderungen fortlaufend an nachgelagerte Systeme. So entfällt das Warten auf geplante Tabellenextraktionen. Bei KI-Anwendungen, die vom Zustand operativer Datenbanken abhängen, kann CDC die Zeit zwischen einer Produktionsänderung und ihrer Verfügbarkeit in Analyse- oder Retrieval-Systemen deutlich verkürzen.
Warum kann ein RAG-System trotz schneller Vektordatenbank veraltet sein?
Die Leistung von Vektorabfragen bestimmt nur die Abrufzeit. Quellinformationen können vorher noch mehrere verzögerte Stufen durchlaufen, bevor sie den Vektorindex erreichen. Extraktion, Transformation, Chunking, Embedding-Erzeugung und Indexaktualisierung können alle Latenz verursachen. Die Aktualität eines RAG-Systems hängt daher von der gesamten Synchronisierungspipeline ab.
Brauchen KI-Agenten niedrigere Datenlatenz als Chatbots?
Oft ja. Ein Chatbot liefert vielleicht eine veraltete Antwort, ein autonomer Agent kann dagegen auf Basis eines veralteten Zustands eine falsche Aktion ausführen. Agenten lesen außerdem häufig eine Ressource, ändern sie und treffen gleich darauf die nächste Entscheidung. Solche Workflows stellen höhere Anforderungen an aktuellen Zustand, Konsistenz und die Sichtbarkeit gerade ausgeführter Aktionen.
Sollte jeder von KI genutzte Datensatz in Echtzeit aktualisiert werden?
Nein. Echtzeitinfrastruktur bringt am meisten, wo veraltete Daten eine wichtige Entscheidung verändern können. Transaktionsstatus, Betrugssignale, Lagerbestände, Kontostatus und betriebliche Ereignisse brauchen eventuell schnelle Updates. Historische Referenzdaten oder relativ statische Dokumentation vertragen oft eine langsamere Synchronisierung. Ein einheitliches Latenzziel für alle Datensätze schafft unnötige Komplexität.

Sapna Ghodasara ist die Gründerin von Guide of AI Tool. Dort schreibt sie ausführliche Testberichte über KI-Tools für Marketer, Creator und Unternehmen. Ihre Tests konzentrieren sich auf das, was vor dem Kauf eines Tools zählt: echte Anwendungsfälle, ehrliche Vor- und Nachteile, Preise und wie gut es in den Arbeitsalltag passt.
Sapna ist Mitgründerin von SEOMagicLab. Die Verbindung aus technischer Ausbildung und täglicher Marketingarbeit erlaubt ihr, KI-Tools aus zwei Blickwinkeln zu beurteilen: wie gut die Technologie tatsächlich funktioniert und ob sie den Menschen, die sie nutzen, echten Mehrwert bringt.