Eine neue Studie berichtet, dass ein gängiges Nahrungsergänzungsmittel den kognitiven Abbau verlangsamt. Innerhalb einer Woche wird sie in Pressemitteilungen, Förderanträgen und Investorenpräsentationen zitiert. Sechs Monate später findet eine größere Studie keinen Effekt, und ein genauerer Blick auf das Original zeigt, dass die Schlussfolgerung weit über das hinausging, was die Daten hergaben. Nichts an der ersten Studie war erfunden. Die Behauptung war einfach stärker als die Belege. Diese Lücke zwischen dem, was eine Studie zeigt, und dem, was sie behauptet, ist eines der häufigsten Probleme der Wissenschaft, und sie wird immer schwerer zu erkennen. Die Zahl der Veröffentlichungen steigt, Preprints kursieren vor der Begutachtung, und Entscheider in Forschung, Pharma und Politik haben selten Zeit, jede Arbeit gründlich zu lesen. KI-Plattformen helfen inzwischen dabei, gehen aber sehr unterschiedlich vor: Manche prüfen, was die Literatur zu einer Behauptung sagt, manche finden verwandte Belege, manche bewerten die Qualität der Methoden, und einige wenige untersuchen die Argumentation innerhalb der Arbeit selbst.
Auf einen Blick
- QED Science: ordnet jede Behauptung einer Arbeit in einen Behauptungsbaum ein und prüft, ob die Belege sie stützen.
- scite: zeigt mit Smart Citations, ob spätere Studien die Ergebnisse einer Arbeit stützen oder ihnen widersprechen.
- Consensus: fasst zusammen, was begutachtete Forschung zu einer wissenschaftlichen Ja-oder-Nein-Frage sagt.
- FutureHouse: bietet KI-Agenten für Literaturrecherche, Vorabprüfungen und Evidenzsynthese.
- Ai2 Asta: ein kostenloser, transparenter Forschungsassistent auf Basis eines großen wissenschaftlichen Korpus.
- Elicit: überträgt Daten und Ergebnisse aus vielen Arbeiten in strukturierte Tabellen.
- Undermind: ein KI-Suchagent, der sehr spezifische Belege für komplexe Fragen findet.
- Reviewer3: Multi-Agenten-Begutachtung von Methodik, Reproduzierbarkeit und Kontext.
- SciScore: bewertet Methodenteile nach Sorgfalt und Angaben zur Reproduzierbarkeit.
Die vier Fragen hinter jeder wissenschaftlichen Behauptung
Eine Behauptung zu bewerten heißt meist, vier verschiedene Fragen zu beantworten. Kein Tool beantwortet alle gleich gut, deshalb macht es den Vergleich klarer, sie zuerst zu verstehen. Dieselbe Gewohnheit hilft, wenn Sie weitergeleitete WhatsApp-Nachrichten mit KI prüfen, doch wissenschaftliche Behauptungen kommen mit zusätzlichen Ebenen aus Methoden, Statistik und Zitaten, die mehr Aufmerksamkeit brauchen.
- Stützen die Belege dieser Arbeit ihre Schlussfolgerungen? Das ist eine Frage der Argumentation: Rechtfertigen Experimente und Daten tatsächlich jede Behauptung, und trägt die logische Kette vom Ergebnis bis zur Schlussfolgerung?
- Was sagt die übrige Literatur? Eine Behauptung kann in sich schlüssig sein und trotzdem einem großen Teil anderer Arbeiten widersprechen. Zur Bestätigung muss man prüfen, wie frühere und spätere Studien sich zu ihr verhalten.
- Wurde das schon einmal getestet, und wie gründlich? Viele vermeintliche Entdeckungen wiederholen frühere Ergebnisse ganz oder teilweise. Die Vorgeschichte zu kennen verändert, wie neu und glaubwürdig eine Behauptung wirkt.
- Waren die Methoden gründlich und gut dokumentiert? Stichprobengröße, Kontrollen, Verblindung, statistische Auswertung und Berichtsqualität bestimmen, wie viel ein Ergebnis tragen kann.
Die folgenden Plattformen konzentrieren sich jeweils auf eine oder mehrere dieser Fragen. Die erste auf der Liste widmet sich direkt der Frage, die am schwersten zu automatisieren ist und am häufigsten übersprungen wird: ob die Belege einer Arbeit stützen, was sie behauptet.
Die 9 besten KI-Plattformen zur Bewertung wissenschaftlicher Behauptungen
1. QED Science
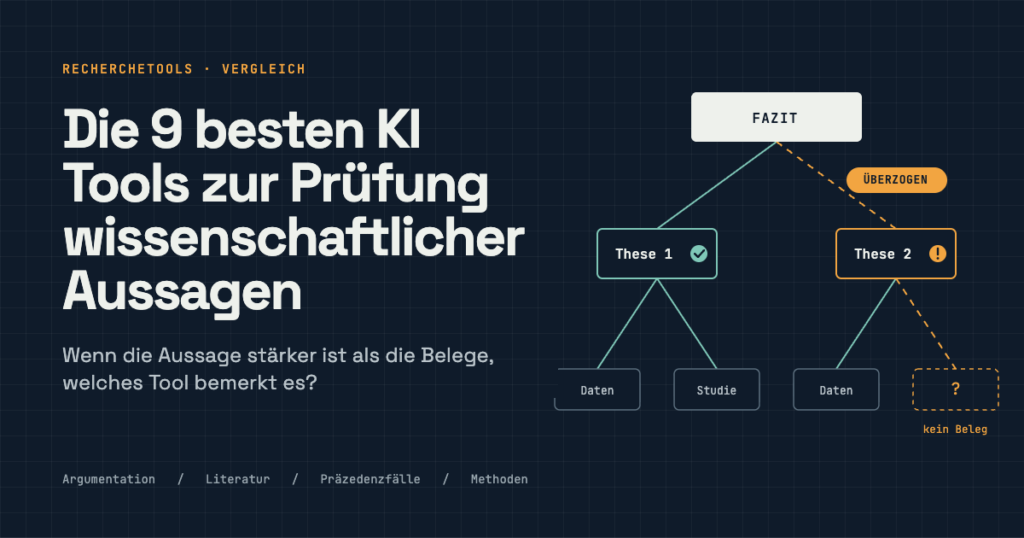
Die meisten KI-Forschungstools bewerten eine Arbeit von außen, indem sie prüfen, was andere Studien über sie sagen oder wie sie sich in die Literatur einfügt. QED Science bewertet sie von innen. Als erste KI-Plattform für kritisches Denken beschrieben, extrahiert sie jede implizite und explizite Behauptung eines Manuskripts, stellt in einem Behauptungsbaum dar, wie diese voneinander abhängen, und prüft, ob Experimente und zitierte Literatur jede einzelne tatsächlich stützen. Das Ergebnis liest sich wie der Kern eines Fachgutachtens. Für jede Behauptung benennt QED Stärken und logische Lücken, markiert Schlussfolgerungen, die über die Belege hinausgehen, und schlägt experimentelle und sprachliche Änderungen vor, etwa eine Behauptung so umzuformulieren, dass sie zu den Daten passt, oder ein Experiment zu ergänzen, das die Lücke schließt. Die Berichte liegen nach etwa 30 Minuten vor, statt nach den Wochen oder Monaten einer formalen Begutachtung. Der Ansatz reicht über einzelne Arbeiten hinaus: Nutzer können eine wissenschaftliche Frage stellen, und QED extrahiert die relevanten Behauptungen aus einem Forschungsbestand, bewertet die Validität jeder einzelnen und hilft, Widersprüche zwischen Studien aufzulösen. Für Organisationen, die Forschung im großen Stil beurteilen müssen, bietet der QED Score eine validierte Qualitätskennzahl, die Manuskripte aus den Lebenswissenschaften nach vollständiger Anonymisierung auf Originalität und Validität bewertet und so den Einfluss von Autor, Institution und Fachzeitschrift ausschaltet. QED demonstrierte die Methode mit The 1%, einer Blindbewertung von 57.455 bioRxiv-Preprints, aus der die 574 besten hervorgingen, beschrieben als bislang größte Blindbewertung der Qualität von Preprints. Die Plattform bewertet außerdem Förderanträge nach Wirkung, Originalität, Stärke der Hypothese und Versuchsdesign und vergleicht die Originalität mit Hunderten verwandter Arbeiten. Wichtige Funktionen:
- Extraktion von Behauptungen und Behauptungsbaum für jede Arbeit
- Abgleich von Belegen und Behauptungen, der überzogene Schlussfolgerungen markiert
- Vorschläge für experimentelle und sprachliche Verbesserungen
- Behauptungsextraktion auf Fragenebene und Validitätsbewertung über Studien hinweg
- QED Score für Originalität und Validität nach vollständiger Anonymisierung
- Bewertung von Förderanträgen und Originalitätsvergleich
- Berichte in etwa 30 Minuten
- Daten bleiben beim Nutzer, kein Modelltraining mit Nutzerinhalten
2. scite
scite beantwortet die Frage der Bestätigung. Die Smart Citations zeigen, wie eine Arbeit von späteren Arbeiten zitiert wurde, und ordnen jedes Zitat als stützend, widersprechend oder lediglich erwähnend ein, wobei der umgebende Text als Kontext sichtbar ist. Diese Ansicht hilft zu prüfen, ob eine Behauptung Bestand hatte. Eine häufig zitierte Arbeit mit vielen widersprechenden Zitaten erzählt eine ganz andere Geschichte als eine, die spätere Studien konsequent bestätigen. scite bietet außerdem einen Assistenten, der mit Quellen antwortet, sowie Tools, um die Zuverlässigkeit des Literaturverzeichnisses eines Manuskripts zu prüfen. Es bewertet eine Arbeit über die Literatur in ihrem Umfeld und untersucht daher nicht ihre innere Logik. Wichtige Funktionen:
- Smart Citations, eingeordnet als stützend, widersprechend oder erwähnend
- Kontext zu jedem Zitat
- KI-Assistent auf Basis von Zitaten
- Prüfung von Literaturverzeichnissen in Manuskripten
3. Consensus
Consensus konzentriert sich darauf, was die Forschungsliteratur zu einer bestimmten Frage sagt. Nutzer stellen eine Frage in Alltagssprache, die Plattform durchsucht begutachtete Arbeiten und fasst die Ergebnisse zusammen, mit einem Consensus Meter, das zeigt, wie sich Studien bei Ja-oder-Nein-Fragen positionieren. Für eine schnelle Prüfung, ob eine Behauptung breit gestützt wird, ist Consensus ein schneller Einstieg mit Links zu den zugrunde liegenden Arbeiten. Die Zusammenfassungen spiegeln das Verhältnis der veröffentlichten Ergebnisse wider, sodass neue oder umstrittene Behauptungen womöglich noch nicht gut abgebildet sind. Wichtige Studien sollten Sie daher lesen, bevor Sie Schlüsse ziehen. Das ist bei allgemeinen Chatbots noch wichtiger, die, wie unser KI-Halluzinationstest gezeigt hat, selbstsichere Antworten ohne echte Quellen liefern können. Wichtige Funktionen:
- Fragen in Alltagssprache, beantwortet aus begutachteter Forschung
- Consensus Meter für Ja-oder-Nein-Fragen
- Studienzusammenfassungen mit Quellenlinks
- Qualitätsindikatoren für einzelne Arbeiten
4. FutureHouse
FutureHouse, eine gemeinnützige Organisation, die KI-Systeme für wissenschaftliche Entdeckungen entwickelt, bietet eine Plattform spezialisierter Forschungsagenten. Crow liefert knappe Antworten mit Quellen, Falcon erstellt tiefgehende Literaturübersichten zur Bewertung von Hypothesen, und Owl führt Vorabrecherchen durch, die zeigen, ob jemand einen bestimmten Ansatz schon ausprobiert hat. Ein experimenteller Agent namens Phoenix unterstützt bei Chemieaufgaben. Die Agenten basieren auf PaperQA2, dem Open-Source-System von FutureHouse zur Suche und Zusammenfassung wissenschaftlicher Literatur, das bei der Beantwortung wissenschaftlicher Fragen und beim Erkennen von Widersprüchen gute Ergebnisse gezeigt hat. Eine Ansicht der Argumentation zeigt die berücksichtigten Arbeiten und Belege, sodass Nutzer nachvollziehen können, wie eine Antwort zustande kam. Wie andere Literaturagenten bewertet es Behauptungen anhand des Veröffentlichten, nicht anhand der inneren Logik eines Manuskripts. Wichtige Funktionen:
- Spezialisierte Agenten für knappe Antworten, tiefe Übersichten und Vorabrecherchen
- Basiert auf dem Open-Source-System PaperQA2
- Sichtbare Argumentation und Belegspur
- Experimenteller Chemie-Agent
5. Ai2 Asta
Ai2 Asta ist ein kostenloser agentischer Forschungsassistent des Allen Institute for AI, der gemeinnützigen Organisation hinter Semantic Scholar. Er greift auf einen Korpus von über 108 Millionen wissenschaftlichen Abstracts und 12 Millionen Volltexten zurück und kombiniert den Paper Finder für die Literatursuche mit einem Zusammenfassungstool, während Datenanalysefunktionen noch in einer eingeschränkten Beta sind. Asta zeichnet sich durch Transparenz aus. Der Paper Finder zeigt jeden Arbeitsschritt, darunter Anfrageanalyse, Suchabläufe und Relevanzbewertungen, sodass Forschende und Bibliothekare die Ergebnisse besser verstehen und ihnen vertrauen können. Damit eignet er sich hervorragend, um die Evidenzbasis rund um eine Behauptung aufzubauen, bewertet aber nicht die Qualität der Behauptung selbst. Wichtige Funktionen:
- Kostenloser Zugang für Forschende
- Korpus mit über 108 Millionen Abstracts und über 12 Millionen Volltexten
- Transparenter Suchprozess Schritt für Schritt
- Literaturzusammenfassung mit Quellenangaben
6. Elicit
Elicit hilft Forschenden, viele Arbeiten gleichzeitig zu bearbeiten. Es findet relevante Studien, fasst Ergebnisse zusammen und überträgt Daten wie Populationen, Interventionen, Endpunkte und Resultate in strukturierte Tabellen, was systematische und schnelle Reviews unterstützt. Um eine Behauptung im Licht eines ganzen Evidenzbestands zu bewerten, lassen sich Studiendesigns und Ergebnisse in diesen Tabellen direkt vergleichen und Abweichungen erkennen. Diese Art der Evidenzprüfung ist auch die Grundlage vieler KI-Tools im Gesundheitswesen, die heute in der Klinik eingesetzt werden. Elicit ist am stärksten beim Ordnen und Extrahieren von Belegen. Ob die Schlussfolgerungen jeder Studie gerechtfertigt sind, muss weiterhin der Prüfer beurteilen. Wichtige Funktionen:
- Datenextraktion aus Arbeiten in strukturierte Tabellen
- Suche und Zusammenfassung von Arbeiten
- Unterstützung systematischer Reviews
- Direkter Vergleich von Studienergebnissen
7. Undermind
Undermind ist ein KI-Suchagent für komplexe wissenschaftliche Fragen. Statt Keywords abzugleichen, nutzt er große Sprachmodelle, um die Literatur adaptiv zu erkunden, so wie es ein erfahrener Forscher tun würde, und das Unternehmen berichtet von deutlichen Verbesserungen gegenüber klassischer Keyword-Suche beim Finden relevanter Arbeiten. Einige Hochschulbibliothekare nutzen ihn als Maßstab für KI-gestützte Literaturrecherche. Besonders nützlich ist er, wenn die Bewertung einer Behauptung davon abhängt, wenige sehr spezifische Studien zu finden. Der Prozess ist weniger sichtbar als bei manchen Alternativen, und der Fokus liegt auf dem Finden, nicht auf der Bewertung der Validität des Gefundenen. Wichtige Funktionen:
- Adaptive Literaturerkundung mit LLMs
- Für komplexe Fragen auf Expertenniveau entwickelt
- Starkes Auffinden sehr spezifischer Studien
- Im Einsatz in Medizin, Biotech und weiteren Bereichen
8. Reviewer3
Reviewer3 nutzt mehrere spezialisierte KI-Agenten, um Methodik, Reproduzierbarkeit und Kontext eines Manuskripts zu bewerten, und liefert in unter zehn Minuten strukturiertes Feedback. Eigene Bewertungskriterien und Zielzeitschriften werden unterstützt. Der Fokus auf Methoden macht es zu einer nützlichen Ergänzung der Analyse auf Behauptungsebene. Es kann Design- und Statistikprobleme schnell aufzeigen, unabhängige Vergleiche beschreiben es jedoch eher als breite Vorprüfung denn als tiefe Analyse, wie einzelne Behauptungen von Belegen abhängen. Wichtige Funktionen:
- Multi-Agenten-Prüfung von Methodik und Reproduzierbarkeit
- Strukturiertes Feedback in unter zehn Minuten
- Eigene Kriterien und Zielzeitschriften
- Transparenzinitiativen, die KI- und menschliche Gutachten vergleichen
9. SciScore
SciScore bewertet den Methodenteil eines Manuskripts auf Sorgfalt und Angaben zur Reproduzierbarkeit. Geprüft werden Elemente wie Randomisierung, Verblindung, Begründung der Stichprobengröße, Berücksichtigung des Geschlechts als Variable und korrekte Kennzeichnung von Forschungsressourcen. Anschließend erstellt das Tool einen Score und einen Bericht darüber, was vorhanden ist und was fehlt. Da SciScore die Berichterstattung und nicht die Schlussfolgerungen untersucht, beantwortet es eine engere Frage als andere Tools in dieser Liste. Es hilft zu beurteilen, ob eine Studie transparent genug beschrieben ist, um ihr zu vertrauen und sie zu reproduzieren, ein wichtiger Faktor dafür, wie viel Gewicht ihre Behauptungen verdienen. Wichtige Funktionen:
- Automatische Prüfung von Sorgfalt und Reproduzierbarkeit
- Erkennung wichtiger Berichtselemente im Methodenteil
- Score und ausführlicher Bericht pro Manuskript
- Unterstützung von Standards zur Ressourcenkennzeichnung
Häufige Fehler beim Einsatz von KI zur Bewertung von Behauptungen
- Zitationszahlen als Bestätigung werten: Eine häufig zitierte Arbeit wird womöglich vor allem zitiert, um ihr zu widersprechen. Prüfen Sie, wie sie zitiert wird, nicht nur wie oft.
- Konsens in der Literatur mit Richtigkeit verwechseln: Eine Behauptung kann der Mehrheitsmeinung entsprechen und trotzdem auf schwacher Argumentation beruhen, während ein neues Ergebnis richtig sein kann, bevor die Literatur nachzieht.
- Bei den Suchergebnissen stehen bleiben: Verwandte Arbeiten zu finden heißt nicht, sie zu bewerten. Suchtools sammeln Belege, aber jemand muss sie noch beurteilen.
- Die innere Logik der Arbeit ignorieren: Viele überzogene Behauptungen entstehen durch Schlussfolgerungen, die über die Daten hinausgehen, ein Problem, das Bestätigungstools selten erkennen.
- Annehmen, dass KI Betrug erkennt: Die meisten Bewertungstools gehen davon aus, dass die Daten echt sind. Datenfälschung und Bildmanipulation erfordern eigene Integritätsprüfungen.
- Reputation an die Stelle der Prüfung setzen: Das Ansehen von Autor, Institution und Zeitschrift prägt Urteile stärker, als die meisten Gutachter zugeben. Anonymisierte Bewertung hilft, den Fokus auf die Belege zu richten.
Das passende Tool für die jeweilige Entscheidung
Unterschiedliche Entscheidungen erfordern unterschiedliche Tool-Kombinationen. Einige typische Situationen zeigen, wie sie zusammenpassen.
Ein Manuskript vor der Einreichung prüfen
Autoren profitieren am meisten von Tools, die ihre eigene Argumentation und ihre Methoden testen. Die Analyse auf Behauptungsebene zeigt, wo Schlussfolgerungen den Daten vorauseilen, während Methoden- und Berichtsprüfungen Lücken aufdecken, die Gutachter wahrscheinlich ansprechen würden. Steht die Argumentation, können KI-Schreibtools helfen, die Sprache vor dem Einreichen zu schärfen.
Förderanträge begutachten
Förderer müssen Hypothesen, Originalität und Versuchsdesign über viele Anträge hinweg beurteilen. Tools, die Anträge direkt bewerten, etwa QED Science, helfen in Kombination mit Vorabrecherchen, die Diskussion auf die stärksten Ideen zu lenken.
Wissenschaftliche Due Diligence in Pharma und Biotech
Bevor Teams in ein Target investieren oder ein Asset lizenzieren, müssen sie wissen, ob die wichtigsten Arbeiten belastbar sind. Die Kombination aus Analyse auf Behauptungsebene, Bestätigungsprüfung und gezielter Literaturrecherche ergibt ein vollständigeres Bild als jeder Ansatz allein.
Journal Clubs und Lehre
Behauptungsbäume und Zitationskontext sind hervorragende Lehrmittel und ein gutes Beispiel dafür, wie KI Studierenden helfen kann, weil sie zeigen, wie Argumente aufgebaut sind und wo sie brechen, statt Arbeiten nur wegen ihrer Schlussfolgerungen zu lesen.

Sapna Ghodasara ist die Gründerin von Guide of AI Tool. Dort schreibt sie ausführliche Testberichte über KI-Tools für Marketer, Creator und Unternehmen. Ihre Tests konzentrieren sich auf das, was vor dem Kauf eines Tools zählt: echte Anwendungsfälle, ehrliche Vor- und Nachteile, Preise und wie gut es in den Arbeitsalltag passt.
Sapna ist Mitgründerin von SEOMagicLab. Die Verbindung aus technischer Ausbildung und täglicher Marketingarbeit erlaubt ihr, KI-Tools aus zwei Blickwinkeln zu beurteilen: wie gut die Technologie tatsächlich funktioniert und ob sie den Menschen, die sie nutzen, echten Mehrwert bringt.