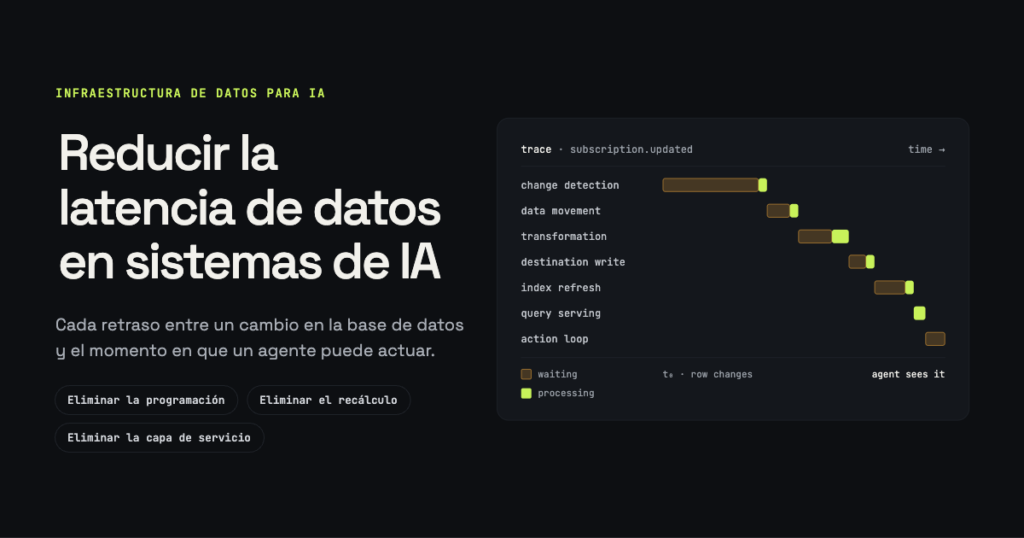
Un sistema de IA no vive la latencia de datos como una sola cifra, sino como una cadena de retrasos. Un cliente actualiza su suscripción en una base de datos de producción. El cambio tiene que detectarse. Tiene que pasar por un pipeline. Puede que haya que cruzarlo con otra información o transformarlo en un objeto de negocio útil. Después, ese resultado quizá tenga que llegar a un data warehouse, un feature store, un índice vectorial, una base de datos analítica o una capa de contexto para agentes. Por último, la aplicación de IA tiene que recuperarlo.
Dónde aparece la latencia en un sistema de IA
Antes de elegir infraestructura, los equipos deberían identificar qué parte del recorrido es realmente lenta.
| Punto de latencia | Qué ocurre | Consecuencia para la IA |
|---|---|---|
| Detección de cambios | Los cambios en el origen esperan al siguiente ciclo de extracción | La IA nunca ve el estado más reciente |
| Movimiento de datos | Los cambios capturados se quedan en colas o microlotes | El contexto llega tarde |
| Transformación | Grandes procesos recalculan conjuntos de datos enteros | Datos brutos recientes se convierten en datos derivados desactualizados |
| Escritura en destino | Los warehouses o bases de datos reciben las actualizaciones de forma ineficiente | La recuperación posterior tiene que esperar |
| Actualización de índice o contexto | Los almacenes vectoriales y el contexto de IA se actualizan periódicamente | El RAG recupera información desactualizada |
| Servicio de consultas | Los datos actuales existen pero tardan en recuperarse | Aumenta el tiempo de respuesta del agente |
| Bucle de acción | La IA espera a ver el efecto de su acción anterior | Los flujos autónomos trabajan con un estado del mundo desactualizado |
6 plataformas para reducir la latencia de datos en sistemas de IA
1. Artie
Artie se centra en una de las fuentes de latencia más comunes en la infraestructura de IA: el tiempo que pasa entre un cambio en una base de datos transaccional y su disponibilidad en el entorno de datos posterior. La plataforma usa change data capture basado en logs para replicar de forma continua inserciones, actualizaciones y borrados desde bases de datos operativas hacia destinos como Snowflake, BigQuery, Redshift y otras bases de datos. En lugar de extraer tablas completas una y otra vez o esperar a procesos por lotes programados, Artie lee los cambios de la base de datos a medida que se producen y los aplica en destino. Su plataforma está pensada para replicar en menos de un minuto sin que los equipos tengan que desplegar ni operar Kafka, Debezium o una infraestructura de streaming propia. Esa arquitectura es útil para las aplicaciones de IA porque muchos de sus datos más importantes ya viven en sistemas transaccionales. El estado del cliente, las suscripciones, los pedidos, los saldos, la actividad en la aplicación, los permisos y los cambios de cuenta suelen nacer en Postgres u otra base de datos OLTP. Cuando esas tablas llegan a un entorno analítico o preparado para IA mediante pipelines por lotes, un agente puede estar trabajando con información que era correcta hace varias horas. Artie también resuelve los problemas operativos asociados. La evolución automática del esquema ayuda a que los pipelines sigan funcionando cuando cambia el esquema de origen, y la observabilidad integrada controla latencia, rendimiento, estado y errores. Las cargas históricas pueden ejecutarse sin detener el flujo en directo, y History Mode puede conservar estados anteriores cuando las cargas de IA o analíticas necesitan algo más que la última fila. La plataforma también ha añadido la ingesta de eventos junto al CDC, para que el estado de la base de datos y la información basada en eventos lleguen a los sistemas posteriores dentro de la misma arquitectura en tiempo real. Para equipos cuya pila de IA gira ya en torno a un warehouse, un lakehouse o una base de datos analítica, Artie ofrece una solución bastante directa a la primera y a menudo más importante fuente de datos desactualizados: sacar los cambios de producción de las bases de datos operativas de forma rápida y fiable.
2. Striim
Striim combina CDC en tiempo real con procesamiento de flujos y una infraestructura de datos cada vez más orientada a la IA. La plataforma captura cambios de fuentes de datos empresariales y los entrega de forma continua en sistemas como Snowflake, BigQuery, Databricks, Redshift, ClickHouse, Microsoft Fabric y otros entornos analíticos. Su arquitectura es especialmente relevante para empresas con bases de datos operativas complejas, infraestructura heterogénea y necesidades de replicación de gran volumen. Para los sistemas de IA, Striim ha ido más allá del movimiento de datos. Su plataforma actual incluye componentes para generar embeddings vectoriales dentro de los propios pipelines de streaming, detectar y proteger información sensible, identificar anomalías y poner datos empresariales en tiempo real a disposición de agentes de IA. Las novedades de 2026 también incorporaron funciones basadas en MCP para que las aplicaciones agénticas trabajen con información empresarial siempre actualizada. Eso elimina un traspaso de arquitectura que de otro modo puede añadir latencia. Un pipeline de RAG convencional podría replicar primero los datos de origen y esperar después a que otro proceso detecte los registros nuevos, genere los embeddings y los entregue en otro sistema. Striim puede hacer ese procesamiento orientado a la IA dentro del propio flujo, lo que acorta el tiempo entre un hecho de negocio y el momento en que su representación semántica se puede usar. La plataforma también permite procesar datos en movimiento: los equipos pueden filtrar, agregar, enriquecer, enmascarar o modificar registros antes de que lleguen a los sistemas de IA.
3. Fivetran HVR
Fivetran HVR está pensado para replicar grandes volúmenes de datos con baja latencia en entornos empresariales. HVR usa CDC basado en logs y una arquitectura distribuida en la que los agentes pueden situarse cerca de las bases de datos y los logs de transacciones. Esto reduce la sobrecarga de capturar grandes volúmenes de cambios y es especialmente relevante para empresas que replican sistemas operativos que no toleran consultas pesadas en el origen. Para la infraestructura de IA, HVR resulta interesante cuando los datos que deben mantenerse al día viven en sistemas transaccionales grandes y consolidados. Muchas iniciativas de IA empresarial acaban topándose con Oracle, SQL Server, entornos relacionados con SAP, bases de datos locales u otros sistemas que nunca se diseñaron para la IA en tiempo real. Sustituir esas fuentes rara vez es realista. Lo que necesitan los equipos de IA es una vía fiable para llevar datos operativos en constante cambio a plataformas cloud donde modelos y agentes puedan usarlos. HVR admite un modo de integración continua para los casos que requieren la mínima latencia de replicación y puede medir la latencia por separado en la captura y en la integración en destino. Los equipos pueden definir SLA de latencia y generar alertas cuando la replicación se sale de los umbrales previstos. Si un agente depende de una tabla de clientes supuestamente actual, el equipo de datos necesita saber si “actual” significa dos segundos por detrás del origen o 20 minutos porque un proceso de replicación va con problemas.
4. Streamkap
Streamkap se basa en CDC gestionado y procesamiento de flujos, con el movimiento de datos por debajo del segundo como objetivo central de diseño. La plataforma captura los cambios de la base de datos mediante CDC basado en logs y los entrega continuamente en warehouses, lakehouses, bases de datos, Kafka y destinos orientados a aplicaciones. Admite orígenes como Postgres, MySQL, MongoDB, SQL Server y Oracle, y permite ejecutar transformaciones mientras la información está en movimiento. En una arquitectura tradicional, los datos pueden capturarse rápido pero después esperar a un proceso de transformación aparte antes de que una aplicación pueda usarlos. Streamkap permite transformar, cruzar, filtrar, enriquecer, enrutar o enmascarar registros con SQL, Python o JavaScript dentro del propio flujo. La empresa indica una latencia P99 de origen a destino inferior a 250 milisegundos en sus pipelines gestionados, y su arquitectura actual orientada a agentes está pensada para ofrecer flujos procesados en directo a sistemas de IA externos. Streamkap también ha lanzado Streaming Agents, ahora en beta, que pueden ejecutar procesamiento con LLM directamente sobre flujos de Kafka. Un agente puede consumir registros, usar un modelo y herramientas opcionales para clasificarlos, enriquecerlos, anonimizarlos o resumirlos, validar el resultado y escribirlo de nuevo en un flujo.
5. RisingWave
RisingWave ataca la latencia después de la captura manteniendo de forma continua el estado que las aplicaciones y los sistemas de IA realmente necesitan. Es una base de datos de streaming compatible con PostgreSQL que puede ingerir flujos y datos de CDC, ejecutar transformaciones SQL continuas y mantener vistas materializadas a medida que llega nueva información. RisingWave indica una latencia de extremo a extremo inferior a 100 milisegundos en cargas de streaming. Este modelo puede eliminar uno de los retrasos más ignorados en las arquitecturas de IA: el recálculo. Imagina que un sistema de IA necesita una puntuación de riesgo del cliente basada en transacciones actuales, datos de la cuenta, actividad histórica y alertas recientes. Capturar las cuatro fuentes en tiempo real no garantiza un resultado fresco si la tabla de riesgo combinada se reconstruye cada 30 minutos. Con una arquitectura incremental, el propio resultado derivado cambia cuando cambian sus entradas. RisingWave actualiza continuamente las vistas materializadas en lugar de volver a ejecutar la consulta completa. Esas vistas pueden consultarse mediante las interfaces estándar de PostgreSQL, de modo que el estado de negocio en vivo queda disponible directamente para aplicaciones y frameworks de agentes. RisingWave 3.0 amplió esta orientación hacia la IA agéntica con ingesta nativa de pgvector, conectores WebSocket y HTTP, entrega exactly once y un soporte más profundo de Apache Iceberg.
6. Tinybird
Tinybird aborda otra parte de la cadena de latencia: convertir los datos que llegan rápidamente en información que una aplicación o un agente de IA pueda consultar al instante. Su plataforma combina infraestructura ClickHouse gestionada con ingesta en streaming, transformaciones SQL, vistas materializadas, endpoints de API y acceso MCP para agentes de IA. Los datos pueden entrar por HTTP, Kafka, almacenamiento cloud, integraciones con bases de datos y otros métodos, y los resultados para la aplicación pueden exponerse como API de baja latencia. Esto importa porque unos datos frescos no sirven de mucho si consultarlos exige una consulta analítica lenta. Los sistemas de IA suelen necesitar contexto predefinido en el momento de la inferencia: la actividad más reciente de una cuenta, métricas agregadas de un producto, estadísticas operativas actuales o eventos recientes que cumplen ciertos criterios. Tinybird permite definir las transformaciones en SQL y publicar el resultado como endpoint de API, en lugar de construir un backend aparte sobre el almacén analítico. Su plataforma indica una latencia de consulta inferior al segundo en cargas analíticas de gran volumen, y las vistas materializadas en tiempo real pueden ir preparando de forma continua los resultados más solicitados.
Tres formas distintas de eliminar la espera
Las plataformas de esta categoría reducen la latencia mediante tres mecanismos muy distintos.
Eliminar la programación
Las plataformas de CDC eliminan el retraso de esperar al siguiente proceso de extracción. En lugar de preguntar cada 15 minutos si algo ha cambiado, consumen los cambios de forma continua. Suele ser la mayor mejora cuando una organización deja atrás el ELT por lotes convencional.
Eliminar el recálculo
Las bases de datos de streaming y los sistemas de transformación incremental evitan reconstruir un conjunto de datos entero cuando solo ha cambiado una pequeña parte. Si una transacción cambia el saldo actual de un cliente, el sistema actualiza el resultado afectado en lugar de reprocesar todo el histórico. Esto gana importancia a medida que el contexto de IA derivado se vuelve más sofisticado.
Eliminar la capa de servicio
Las plataformas analíticas en tiempo real pueden exponer la información procesada directamente mediante API o interfaces de consulta de baja latencia. Así se evita mover los datos una vez más a una caché o a una base de datos de aplicación solo porque la plataforma analítica es demasiado lenta para una petición en producción. La mejor arquitectura de IA puede combinar las tres cosas: capturar los cambios de forma continua, actualizar el estado derivado de forma incremental y exponer el resultado mediante una interfaz de baja latencia.
Reducir la latencia sin perder fiabilidad
La baja latencia solo sirve si los datos siguen siendo fiables. Las arquitecturas muy agresivas pueden crear nuevos problemas si los equipos optimizan únicamente la velocidad. Un pipeline puede entregar datos rápidamente pero duplicar eventos durante una recuperación. Un cambio de esquema puede eliminar sin avisar un campo que usa una función de IA. Los eventos desordenados pueden generar un estado actual incorrecto. Un fallo de escritura en destino puede dejar visible solo una parte de una transacción. Por eso la IA en producción necesita datos frescos y correctos a la vez. Algunas capacidades importantes son:
- Garantías de entrega
- Evolución del esquema
- Orden cuando sea necesario
- Cargas históricas
- Reproducción
- Gestión de mensajes fallidos
- Monitorización de pipelines
- Validación de datos
- Recuperación sin interrumpir el procesamiento en directo
El objetivo no es mover los datos lo más rápido posible pase lo que pase, sino reducir al mínimo el tiempo necesario para que un estado nuevo y correcto esté disponible para el sistema de IA.
Preguntas frecuentes
¿Pueden los sistemas de IA llegar a una latencia de datos cero?
Ningún sistema distribuido en producción tiene literalmente latencia cero. El objetivo práctico es eliminar las esperas evitables y reducir el retraso de extremo a extremo hasta que sea insignificante para el caso de uso. Según la carga, eso puede significar milisegundos, segundos o varios minutos. Un buen objetivo debe basarse en lo rápido que la información desactualizada empieza a afectar a las decisiones.
¿Cómo reduce el CDC la latencia de datos en IA?
El change data capture lee las inserciones, actualizaciones y borrados de los logs de transacciones de la base de datos y envía esos cambios de forma continua a los sistemas posteriores. Así no hay que esperar a extracciones de tablas programadas. En aplicaciones de IA que dependen del estado de bases de datos operativas, el CDC puede reducir mucho el tiempo entre un cambio en producción y su disponibilidad en los sistemas analíticos o de recuperación.
¿Por qué un sistema RAG puede estar desactualizado aunque tenga una base de datos vectorial rápida?
El rendimiento de las consultas vectoriales solo determina el tiempo de recuperación. La información de origen puede pasar por varias etapas con retraso antes de llegar al índice vectorial: extracción, transformación, generación de fragmentos, creación de embeddings y actualización del índice pueden añadir latencia. Por eso la frescura de un RAG depende de todo el pipeline de sincronización.
¿Necesitan los agentes de IA menos latencia que los chatbots?
A menudo sí. Un chatbot puede dar una respuesta desactualizada, pero un agente autónomo puede ejecutar una acción incorrecta basándose en un estado antiguo. Además, los agentes suelen leer un recurso, modificarlo y tomar otra decisión justo después. Esos flujos exigen más en cuanto a estado actual, coherencia y visibilidad de las acciones recién ejecutadas.
¿Deben actualizarse en tiempo real todos los datos que usa la IA?
No. La infraestructura en tiempo real aporta más valor donde los datos desactualizados pueden cambiar una decisión importante. El estado de las transacciones, las señales de fraude, el inventario, el estado de las cuentas y los eventos operativos pueden necesitar actualizaciones rápidas. La información histórica de referencia o la documentación relativamente estática suele tolerar una sincronización más lenta. Aplicar el mismo objetivo de latencia a todos los datos genera una complejidad innecesaria.

Sapna Ghodasara es la fundadora de Guide of AI Tool, donde escribe análisis en profundidad de herramientas de IA para profesionales del marketing, creadores y empresas. Sus análisis se centran en lo que importa antes de pagar por una herramienta: casos de uso reales, ventajas e inconvenientes sin adornos, precios y cómo encaja en el trabajo del día a día.
Sapna es cofundadora de SEOMagicLab. Esa combinación de formación técnica y trabajo diario en marketing le permite valorar las herramientas de IA desde dos ángulos: cómo rinde realmente la tecnología y si aporta valor real a quienes la usan.