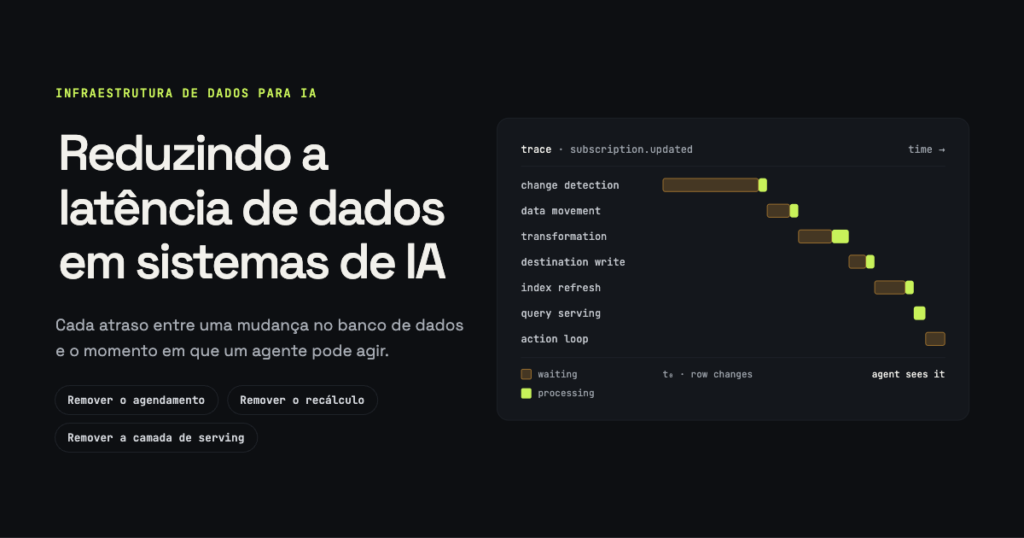
Um sistema de IA não sente a latência de dados como um único número, e sim como uma cadeia de atrasos. Um cliente atualiza a assinatura num banco de dados de produção. A mudança precisa ser detectada. Precisa passar por um pipeline. Talvez precise ser cruzada com outras informações ou transformada num objeto de negócio útil. Depois, esse resultado pode ter de chegar a um data warehouse, um feature store, um índice vetorial, um banco de dados analítico ou uma camada de contexto para agentes. Por fim, a aplicação de IA precisa recuperá-lo.
Onde a latência entra num sistema de IA
Antes de escolher a infraestrutura, as equipes devem identificar qual parte do caminho é realmente lenta.
| Ponto de latência | O que acontece | Consequência para a IA |
|---|---|---|
| Detecção de mudanças | As mudanças na origem esperam o próximo ciclo de extração | A IA nunca vê o estado mais recente |
| Movimentação de dados | As mudanças capturadas ficam paradas em filas ou microlotes | O contexto chega atrasado |
| Transformação | Grandes processos recalculam conjuntos de dados inteiros | Dados brutos novos viram dados derivados desatualizados |
| Gravação no destino | Warehouses ou bancos de dados recebem as atualizações de forma ineficiente | A recuperação seguinte precisa esperar |
| Atualização de índice ou contexto | Bancos vetoriais e contexto de IA são atualizados periodicamente | O RAG recupera informações desatualizadas |
| Atendimento de consultas | Os dados atuais existem, mas demoram a ser recuperados | O tempo de resposta do agente aumenta |
| Ciclo de ação | A IA espera para ver o efeito da ação anterior | Fluxos autônomos operam com um estado do mundo desatualizado |
6 plataformas para reduzir a latência de dados em sistemas de IA
1. Artie
A Artie foca numa das fontes de latência mais comuns na infraestrutura de IA: o intervalo entre uma mudança num banco de dados transacional e sua disponibilidade no ambiente de dados seguinte. A plataforma usa change data capture baseado em logs para replicar continuamente inserções, atualizações e exclusões de bancos operacionais para destinos como Snowflake, BigQuery, Redshift e outros bancos de dados. Em vez de extrair tabelas inteiras repetidamente ou esperar jobs em lote agendados, a Artie lê as mudanças do banco à medida que acontecem e as aplica no destino. A plataforma foi pensada para replicar em menos de um minuto sem que as equipes precisem implantar e operar Kafka, Debezium ou uma stack de streaming própria. Essa arquitetura é útil para aplicações de IA porque muitos dos fatos mais importantes já estão em sistemas transacionais. Status do cliente, assinaturas, pedidos, saldos, atividade no app, permissões e mudanças de conta costumam nascer no Postgres ou em outro banco OLTP. Quando essas tabelas chegam a um ambiente analítico ou preparado para IA por pipelines em lote, um agente pode estar trabalhando com informações que eram corretas horas atrás. A Artie também cuida dos problemas operacionais ao redor. A evolução automática do esquema ajuda os pipelines a continuar funcionando quando o esquema de origem muda, e a observabilidade nativa acompanha latência, vazão, saúde e erros. Cargas históricas podem rodar sem parar o fluxo ao vivo, e o History Mode pode preservar estados anteriores quando cargas de IA ou analíticas precisam de mais do que a linha mais recente. A plataforma também adicionou ingestão de eventos ao lado do CDC, permitindo que o estado do banco e as informações baseadas em eventos cheguem aos sistemas seguintes pela mesma arquitetura em tempo real. Para equipes cuja stack de IA já gira em torno de um warehouse, lakehouse ou banco analítico, a Artie oferece uma solução bem direta para a primeira e muitas vezes mais importante fonte de dados desatualizados: tirar as mudanças de produção dos bancos operacionais de forma rápida e confiável.
2. Striim
A Striim combina CDC em tempo real com processamento de streams e uma infraestrutura de dados cada vez mais voltada à IA. A plataforma captura mudanças de fontes de dados corporativas e as entrega continuamente em sistemas como Snowflake, BigQuery, Databricks, Redshift, ClickHouse, Microsoft Fabric e outros ambientes analíticos. Sua arquitetura é especialmente relevante para empresas com bancos operacionais complexos, infraestrutura heterogênea e necessidade de replicação em alto volume. Para sistemas de IA, a Striim foi além da movimentação de dados. A plataforma atual inclui componentes para gerar embeddings vetoriais dentro dos pipelines de streaming, detectar e proteger informações sensíveis, identificar anomalias e disponibilizar dados corporativos em tempo real para agentes de IA. As atualizações de 2026 também trouxeram recursos baseados em MCP para que aplicações agênticas trabalhem com informações corporativas sempre atuais. Isso elimina uma passagem de arquitetura que poderia gerar latência. Um pipeline de RAG convencional replicaria primeiro os dados de origem e depois esperaria outro job detectar os novos registros, gerar embeddings e entregá-los em outro sistema. A Striim pode fazer esse processamento voltado à IA dentro do próprio fluxo, reduzindo o intervalo entre um evento de negócio e o momento em que sua representação semântica pode ser usada. A plataforma também processa dados em movimento: as equipes podem filtrar, agregar, enriquecer, mascarar ou modificar registros antes que cheguem aos sistemas de IA.
3. Fivetran HVR
O Fivetran HVR foi feito para replicação de alto volume e baixa latência em ambientes corporativos. O HVR usa CDC baseado em logs e uma arquitetura distribuída em que os agentes ficam próximos dos bancos de dados e dos logs de transação. Isso reduz o esforço de capturar grandes volumes de mudanças e é especialmente relevante para empresas que replicam sistemas operacionais que não suportam consultas pesadas na origem. Para a infraestrutura de IA, o HVR fica interessante quando os dados que precisam estar atualizados vivem em sistemas transacionais grandes e consolidados. Muitas iniciativas de IA corporativa acabam esbarrando em Oracle, SQL Server, ambientes ligados ao SAP, bancos locais ou outros sistemas que nunca foram projetados para IA em tempo real. Substituir essas fontes raramente é realista. O que as equipes de IA precisam é de um caminho confiável para levar dados operacionais em constante mudança a plataformas de nuvem onde modelos e agentes possam usá-los. O HVR oferece um modo de integração contínua para casos que exigem latência mínima e consegue monitorar a latência separadamente na captura e na integração com o destino. As equipes podem definir SLAs de latência e gerar alertas quando a replicação sai dos limites esperados. Se um agente depende de uma tabela de clientes supostamente atual, a equipe de dados precisa saber se “atual” significa dois segundos atrás da origem ou 20 minutos porque um processo de replicação está com dificuldade.
4. Streamkap
O Streamkap foi construído em torno de CDC gerenciado e processamento de streams, com movimentação de dados em menos de um segundo como objetivo central. A plataforma captura mudanças do banco de dados por CDC baseado em logs e as entrega continuamente em warehouses, lakehouses, bancos de dados, Kafka e destinos voltados a aplicações. Ele aceita origens como Postgres, MySQL, MongoDB, SQL Server e Oracle e permite rodar transformações enquanto a informação está em movimento. Numa arquitetura tradicional, os dados podem ser capturados rápido, mas depois esperam um job de transformação separado antes de serem úteis para uma aplicação. O Streamkap permite transformar, cruzar, filtrar, enriquecer, rotear ou mascarar registros com SQL, Python ou JavaScript dentro do próprio fluxo. A empresa informa latência P99 da origem ao destino abaixo de 250 milissegundos nos pipelines gerenciados, e sua arquitetura atual voltada a agentes foi pensada para entregar streams processados ao vivo a sistemas de IA externos. O Streamkap também lançou os Streaming Agents, ainda em beta, que podem rodar processamento com LLM diretamente sobre streams do Kafka. Um agente pode consumir registros, usar um modelo e ferramentas opcionais para classificar, enriquecer, ocultar dados ou resumir, validar o resultado e gravá-lo de volta num stream.
5. RisingWave
O RisingWave ataca a latência depois da captura, mantendo continuamente o estado de que aplicações e sistemas de IA realmente precisam. É um banco de dados de streaming compatível com PostgreSQL que ingere streams e dados de CDC, executa transformações SQL contínuas e mantém views materializadas à medida que novas informações chegam. O RisingWave informa latência de ponta a ponta abaixo de 100 milissegundos em cargas de streaming. Esse modelo pode eliminar um dos atrasos mais ignorados nas arquiteturas de IA: o recálculo. Imagine que um sistema de IA precise de uma pontuação de risco do cliente baseada em transações atuais, dados da conta, atividade histórica e alertas recentes. Capturar as quatro fontes em tempo real não garante um resultado atual se a tabela de risco combinada é reconstruída a cada 30 minutos. Numa arquitetura incremental, o próprio resultado derivado muda quando as entradas mudam. O RisingWave atualiza continuamente as views materializadas em vez de rodar de novo a consulta completa. Essas views podem ser acessadas pelas interfaces padrão do PostgreSQL, deixando o estado de negócio ao vivo disponível diretamente para aplicações e frameworks de agentes. O RisingWave 3.0 ampliou essa direção para a IA agêntica com ingestão nativa de pgvector, conectores WebSocket e HTTP, entrega exactly once e suporte mais profundo ao Apache Iceberg.
6. Tinybird
O Tinybird cuida de outra parte da cadeia de latência: transformar dados que chegam rapidamente em informação que uma aplicação ou um agente de IA possa consultar na hora. A plataforma combina infraestrutura ClickHouse gerenciada com ingestão em streaming, transformações SQL, views materializadas, endpoints de API e acesso MCP para agentes de IA. Os dados podem entrar por HTTP, Kafka, armazenamento em nuvem, integrações com bancos de dados e outros métodos, e os resultados para a aplicação podem ser expostos como APIs de baixa latência. Isso importa porque dados atuais não ajudam muito se servi-los exige uma consulta analítica lenta. Sistemas de IA muitas vezes precisam de contexto predefinido no momento da inferência: a atividade mais recente de uma conta, métricas agregadas de um produto, estatísticas operacionais atuais ou eventos recentes que atendem a certos critérios. O Tinybird permite definir transformações em SQL e publicar o resultado como endpoint de API, em vez de construir um backend separado em torno do armazenamento analítico. A plataforma informa latência de consulta abaixo de um segundo em cargas analíticas de alto volume, e as views materializadas em tempo real podem preparar continuamente os resultados mais pedidos.
Três formas diferentes de eliminar a espera
As plataformas desta categoria reduzem a latência por meio de três mecanismos bem diferentes.
Eliminar o agendamento
As plataformas de CDC eliminam o atraso de esperar o próximo job de extração. Em vez de perguntar a cada 15 minutos se algo mudou, elas consomem as mudanças continuamente. Essa costuma ser a maior melhoria quando uma organização deixa para trás o ELT em lote convencional.
Eliminar o recálculo
Bancos de dados de streaming e sistemas de transformação incremental evitam reconstruir um conjunto de dados inteiro quando só uma pequena parte mudou. Se uma transação altera o saldo atual de um cliente, o sistema atualiza o resultado afetado em vez de reprocessar todo o histórico. Isso fica mais importante à medida que o contexto de IA derivado se torna mais sofisticado.
Eliminar a camada de serviço
Plataformas analíticas em tempo real podem expor a informação processada diretamente por APIs ou interfaces de consulta de baixa latência. Isso evita mover os dados mais uma vez para um cache ou banco de aplicação só porque a plataforma analítica é lenta demais para uma requisição em produção. A melhor arquitetura de IA pode combinar as três coisas: capturar mudanças continuamente, atualizar o estado derivado de forma incremental e expor o resultado por uma interface de baixa latência.
Reduzir a latência sem perder confiabilidade
A baixa latência só é útil se os dados continuarem confiáveis. Arquiteturas agressivas podem criar novos problemas se as equipes otimizarem apenas a velocidade. Um pipeline pode entregar dados rápido, mas duplicar eventos durante uma recuperação. Uma mudança de esquema pode remover sem aviso um campo usado por um recurso de IA. Eventos fora de ordem podem gerar um estado atual errado. Uma falha de gravação no destino pode deixar visível só parte de uma transação. Por isso, a IA em produção precisa de dados atuais e corretos ao mesmo tempo. Recursos importantes incluem:
- Garantias de entrega
- Evolução do esquema
- Ordenação quando necessário
- Cargas históricas
- Reprocessamento
- Tratamento de mensagens com falha
- Monitoramento de pipelines
- Validação de dados
- Recuperação sem interromper o processamento ao vivo
O objetivo não é mover os dados o mais rápido possível a qualquer custo, e sim minimizar o tempo necessário para que um estado novo e correto fique disponível para o sistema de IA.
Perguntas frequentes
Sistemas de IA conseguem ter latência de dados zero?
Nenhum sistema distribuído em produção tem latência literalmente zero. O objetivo prático é eliminar esperas evitáveis e reduzir o atraso de ponta a ponta até que ele seja insignificante para o caso de uso. Dependendo da carga, isso pode significar milissegundos, segundos ou alguns minutos. Uma boa meta deve se basear em quão rápido a informação desatualizada começa a afetar as decisões.
Como o CDC reduz a latência de dados na IA?
O change data capture lê inserções, atualizações e exclusões nos logs de transação do banco e envia essas mudanças continuamente aos sistemas seguintes. Assim não é preciso esperar extrações agendadas de tabelas. Em aplicações de IA que dependem do estado de bancos operacionais, o CDC pode reduzir bastante o intervalo entre uma mudança em produção e sua disponibilidade em sistemas analíticos ou de recuperação.
Por que um sistema RAG pode estar desatualizado mesmo com um banco vetorial rápido?
O desempenho da consulta vetorial controla apenas o tempo de recuperação. A informação de origem ainda pode passar por várias etapas com atraso antes de chegar ao índice vetorial. Extração, transformação, geração de trechos, criação de embeddings e atualização do índice podem adicionar latência. Por isso, a atualidade de um RAG depende de todo o pipeline de sincronização.
Agentes de IA precisam de latência menor que chatbots?
Muitas vezes, sim. Um chatbot pode dar uma resposta desatualizada, mas um agente autônomo pode executar uma ação errada com base num estado antigo. Os agentes também costumam ler um recurso, modificá-lo e logo tomar outra decisão. Esses fluxos exigem mais em termos de estado atual, consistência e visibilidade das ações recém executadas.
Todos os dados usados pela IA devem ser atualizados em tempo real?
Não. A infraestrutura em tempo real tem mais valor onde dados desatualizados podem mudar uma decisão importante. Status de transações, sinais de fraude, estoque, estado de contas e eventos operacionais podem precisar de atualizações rápidas. Informações históricas de referência ou documentação relativamente estática costumam tolerar uma sincronização mais lenta. Aplicar a mesma meta de latência a todos os dados cria complexidade desnecessária.

Sapna Ghodasara é a fundadora do Guide of AI Tool, onde escreve análises aprofundadas de ferramentas de IA para profissionais de marketing, criadores e empresas. Suas análises focam no que importa antes de pagar por uma ferramenta: casos de uso reais, prós e contras honestos, preços e como ela se encaixa no trabalho do dia a dia.
Sapna é cofundadora da SEOMagicLab. Essa combinação de formação técnica e trabalho diário com marketing permite que ela avalie ferramentas de IA por dois ângulos: o desempenho real da tecnologia e o valor concreto que ela entrega a quem a usa.