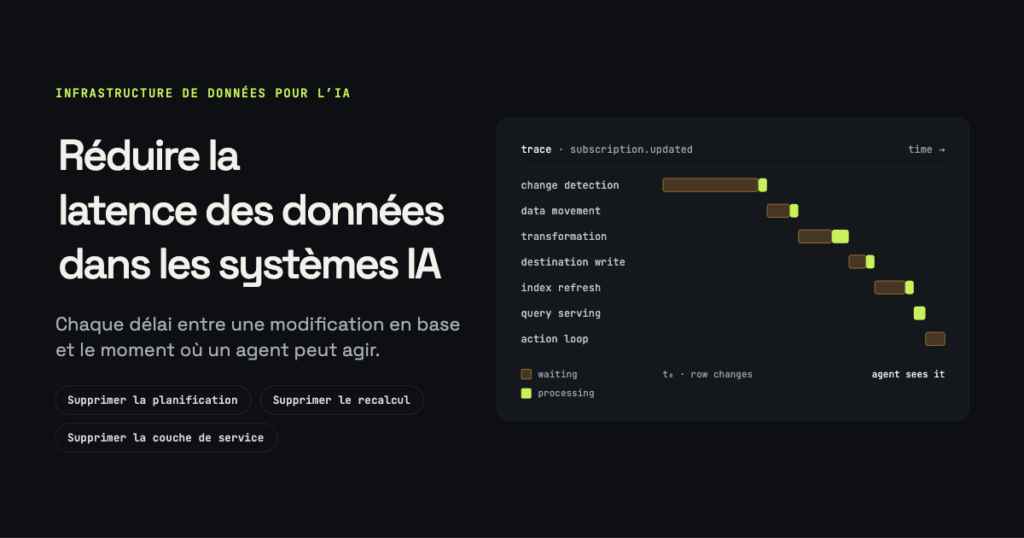
Un système d’IA ne subit pas la latence des données comme un chiffre unique, mais comme une succession de délais. Un client modifie son abonnement dans une base de données de production. Le changement doit être détecté. Il doit traverser un pipeline. Il faudra peut-être le croiser avec d’autres informations ou le transformer en objet métier utile. Le résultat devra ensuite arriver dans un entrepôt de données, un feature store, un index vectoriel, une base analytique ou une couche de contexte pour agents. Enfin, l’application d’IA doit le récupérer.
Où la latence s’introduit dans un système d’IA
Avant de choisir une infrastructure, les équipes doivent identifier quelle partie du parcours est réellement lente.
| Point de latence | Ce qui se passe | Conséquence pour l’IA |
|---|---|---|
| Détection des changements | Les changements à la source attendent le prochain cycle d’extraction | L’IA ne voit jamais l’état le plus récent |
| Déplacement des données | Les changements capturés restent dans des files ou des micro-lots | Le contexte arrive en retard |
| Transformation | De gros traitements recalculent des jeux de données entiers | Des données brutes fraîches deviennent des données dérivées périmées |
| Écriture en destination | Les entrepôts ou bases reçoivent les mises à jour de façon inefficace | La récupération en aval attend |
| Mise à jour de l’index ou du contexte | Les bases vectorielles et le contexte IA sont actualisés périodiquement | Le RAG récupère des informations obsolètes |
| Service des requêtes | Les données actuelles existent mais sont lentes à récupérer | Le temps de réponse de l’agent augmente |
| Boucle d’action | L’IA attend de voir l’effet de son action précédente | Les workflows autonomes agissent sur un état du monde dépassé |
6 plateformes pour réduire la latence des données dans les systèmes d’IA
1. Artie
Artie s’attaque à l’une des sources de latence les plus courantes dans l’infrastructure IA : le délai entre un changement dans une base transactionnelle et sa disponibilité dans l’environnement de données en aval. La plateforme utilise le change data capture fondé sur les logs pour répliquer en continu les insertions, mises à jour et suppressions depuis les bases opérationnelles vers des destinations comme Snowflake, BigQuery, Redshift et d’autres bases. Plutôt que d’extraire sans cesse des tables complètes ou d’attendre des traitements par lots programmés, Artie lit les changements au fil de l’eau et les applique en aval. Sa plateforme est conçue pour une réplication en moins d’une minute sans que les équipes aient à déployer et exploiter Kafka, Debezium ou une pile de streaming maison. Cette architecture est utile aux applications d’IA, car beaucoup de leurs informations les plus importantes vivent déjà dans des systèmes transactionnels. Statut client, abonnements, commandes, soldes, activité applicative, permissions et changements de compte naissent souvent dans Postgres ou une autre base OLTP. Quand ces tables arrivent dans un environnement analytique ou prêt pour l’IA via des pipelines par lots, un agent peut travailler sur des informations exactes il y a plusieurs heures. Artie gère aussi les problèmes opérationnels associés. L’évolution automatique du schéma aide les pipelines à continuer quand le schéma source change, et l’observabilité intégrée suit la latence, le débit, la santé et les erreurs. Les chargements historiques peuvent tourner sans arrêter le flux en direct, et History Mode peut conserver les états précédents quand les charges IA ou analytiques ont besoin de plus que la dernière ligne. La plateforme a aussi ajouté l’ingestion d’événements aux côtés du CDC, pour faire circuler l’état des bases et les informations événementielles dans la même architecture temps réel. Pour les équipes dont la pile IA s’articule déjà autour d’un entrepôt, d’un lakehouse ou d’une base analytique, Artie offre une solution assez directe à la première et souvent principale source de données périmées : sortir rapidement et de façon fiable les changements de production des bases opérationnelles.
2. Striim
Striim associe CDC en temps réel, traitement de flux et une infrastructure de données de plus en plus pensée pour l’IA. La plateforme capte les changements des sources de données de l’entreprise et les livre en continu dans des systèmes comme Snowflake, BigQuery, Databricks, Redshift, ClickHouse, Microsoft Fabric et d’autres environnements analytiques. Son architecture est particulièrement pertinente pour les entreprises aux bases opérationnelles complexes, à l’infrastructure hétérogène et aux besoins de réplication à fort volume. Pour les systèmes d’IA, Striim va au delà du simple déplacement de données. Sa plateforme comprend des composants pour générer des embeddings vectoriels directement dans les pipelines de streaming, détecter et protéger les informations sensibles, repérer les anomalies et mettre les données d’entreprise en temps réel à disposition des agents IA. Les nouveautés 2026 ont aussi introduit des fonctions fondées sur MCP pour que les applications agentiques travaillent avec des informations toujours à jour. Cela supprime une étape de transfert qui peut sinon ajouter de la latence. Un pipeline RAG classique réplique d’abord les données sources, puis attend qu’un traitement séparé détecte les nouveaux enregistrements, génère les embeddings et les livre dans un autre système. Striim peut réaliser ce traitement orienté IA au sein du flux lui-même, réduisant l’intervalle entre un événement métier et le moment où sa représentation sémantique devient exploitable. La plateforme traite aussi les données en mouvement : les équipes peuvent filtrer, agréger, enrichir, masquer ou modifier les enregistrements avant qu’ils n’atteignent les systèmes d’IA.
3. Fivetran HVR
Fivetran HVR est conçu pour la réplication à fort volume et faible latence dans les environnements d’entreprise. HVR utilise un CDC fondé sur les logs et une architecture distribuée dans laquelle des agents sont placés près des bases de données et des journaux de transactions. Cela réduit la charge liée à la capture de grands volumes de changements, ce qui compte pour les entreprises qui répliquent des systèmes opérationnels incapables de supporter de lourdes requêtes à la source. Pour l’infrastructure IA, HVR devient intéressant quand les données à garder à jour vivent dans de grands systèmes transactionnels établis. Beaucoup d’initiatives d’IA en entreprise finissent par rencontrer Oracle, SQL Server, des environnements liés à SAP, des bases sur site ou d’autres systèmes jamais pensés pour l’IA en temps réel. Les remplacer est rarement réaliste. Les équipes IA ont plutôt besoin d’une voie fiable pour amener ces données opérationnelles en perpétuel changement vers des plateformes cloud où modèles et agents peuvent les consommer. HVR propose un mode d’intégration continue pour les cas qui exigent une latence de réplication minimale et peut mesurer la latence séparément à la capture et à l’intégration en destination. Les équipes peuvent définir des SLA de latence et déclencher des alertes quand la réplication sort des seuils prévus. Si un agent dépend d’une table clients censée être à jour, l’équipe data doit savoir si « à jour » signifie deux secondes de retard sur la source ou 20 minutes parce qu’un processus de réplication peine.
4. Streamkap
Streamkap repose sur un CDC managé et le traitement de flux, avec un déplacement des données en moins d’une seconde comme objectif central. La plateforme capte les changements des bases via un CDC fondé sur les logs et les livre en continu dans des entrepôts, lakehouses, bases de données, Kafka et destinations applicatives. Elle prend en charge des sources comme Postgres, MySQL, MongoDB, SQL Server et Oracle et permet d’exécuter des transformations pendant que l’information circule. Dans une architecture classique, les données peuvent être capturées vite mais attendre ensuite un traitement de transformation séparé avant d’être utilisables par une application. Streamkap permet de transformer, joindre, filtrer, enrichir, router ou masquer les enregistrements en SQL, Python ou JavaScript directement dans le flux. L’entreprise annonce une latence P99 de la source à la destination inférieure à 250 millisecondes pour ses pipelines managés, et son architecture orientée agents est pensée pour fournir des flux traités en direct à des systèmes d’IA externes. Streamkap a aussi lancé Streaming Agents, en bêta, qui exécutent du traitement par LLM directement sur des flux Kafka. Un agent peut consommer des enregistrements, utiliser un modèle et des outils optionnels pour les classer, les enrichir, les caviarder ou les résumer, valider le résultat et le réécrire dans un flux.
5. RisingWave
RisingWave s’attaque à la latence après la capture en maintenant en continu l’état dont les applications et les systèmes d’IA ont réellement besoin. C’est une base de streaming compatible PostgreSQL qui ingère des flux et des données CDC, exécute des transformations SQL continues et maintient des vues matérialisées à mesure que les informations arrivent. RisingWave annonce une latence de bout en bout inférieure à 100 millisecondes pour les charges de streaming. Ce modèle peut supprimer l’un des délais les plus négligés dans les architectures IA : le recalcul. Imaginons qu’un système d’IA ait besoin d’un score de risque client fondé sur les transactions actuelles, les informations du compte, l’historique d’activité et les alertes récentes. Capturer ces quatre sources en temps réel ne garantit pas un résultat frais si la table de risque combinée est reconstruite toutes les 30 minutes. Avec une architecture incrémentale, le résultat dérivé change dès que ses entrées changent. RisingWave met à jour en continu les vues matérialisées au lieu de relancer la requête complète. Ces vues sont accessibles via les interfaces PostgreSQL standard, ce qui met l’état métier en direct à la disposition des applications et des frameworks d’agents. RisingWave 3.0 a poursuivi dans cette direction vers l’IA agentique avec l’ingestion native pgvector, des connecteurs WebSocket et HTTP, une livraison exactly once et une prise en charge plus poussée d’Apache Iceberg.
6. Tinybird
Tinybird traite un autre maillon de la chaîne de latence : transformer des données qui arrivent vite en informations qu’une application ou un agent IA peut interroger immédiatement. Sa plateforme associe une infrastructure ClickHouse managée à l’ingestion en streaming, aux transformations SQL, aux vues matérialisées, aux endpoints d’API et à un accès MCP pour les agents IA. Les données peuvent arriver par HTTP, Kafka, stockage cloud, intégrations de bases de données et d’autres moyens, et les résultats destinés aux applications peuvent être exposés sous forme d’API à faible latence. C’est important, car des données fraîches ne servent pas à grand chose si leur service exige une requête analytique lente. Les systèmes d’IA ont souvent besoin d’un contexte prédéfini au moment de l’inférence : la dernière activité d’un compte, des métriques agrégées sur un produit, des statistiques opérationnelles actuelles ou des événements récents répondant à certains critères. Tinybird permet de définir les transformations en SQL et de publier le résultat comme endpoint d’API, au lieu de construire un backend séparé autour du stockage analytique. La plateforme annonce une latence de requête inférieure à la seconde pour les charges analytiques à fort volume, et les vues matérialisées en temps réel peuvent préparer en continu les résultats les plus demandés.
Trois façons différentes de supprimer l’attente
Les plateformes de cette catégorie réduisent la latence grâce à trois mécanismes fondamentalement différents.
Supprimer la planification
Les plateformes CDC suppriment le délai lié à l’attente du prochain traitement d’extraction. Au lieu de vérifier toutes les 15 minutes si quelque chose a changé, elles consomment les changements en continu. C’est généralement le plus gros gain quand une organisation abandonne l’ELT par lots classique.
Supprimer le recalcul
Les bases de streaming et les systèmes de transformation incrémentale évitent de reconstruire un jeu de données entier quand seule une petite partie a changé. Si une transaction modifie le solde actuel d’un client, le système met à jour le résultat concerné au lieu de retraiter tout l’historique. Cela devient crucial à mesure que le contexte IA dérivé se complexifie.
Supprimer la couche de service
Les plateformes analytiques temps réel peuvent exposer directement les informations traitées via des API ou des interfaces de requête à faible latence. On évite ainsi de déplacer encore les données vers un cache ou une base applicative séparée simplement parce que la plateforme analytique est trop lente pour une requête de production. La meilleure architecture IA peut combiner les trois : capter les changements en continu, mettre à jour l’état dérivé de façon incrémentale et exposer le résultat via une interface à faible latence.
Réduire la latence sans sacrifier la fiabilité
Une faible latence n’a d’intérêt que si les données restent fiables. Des architectures trop agressives peuvent créer de nouveaux problèmes si les équipes n’optimisent que la vitesse. Un pipeline peut livrer vite mais dupliquer des événements lors d’une reprise. Un changement de schéma peut supprimer en silence un champ utilisé par une fonction IA. Des événements désordonnés peuvent produire un état actuel erroné. Un échec d’écriture en destination peut ne laisser visible qu’une partie d’une transaction. L’IA en production a donc besoin à la fois de fraîcheur et d’exactitude. Parmi les capacités importantes :
- Garanties de livraison
- Évolution du schéma
- Ordonnancement si nécessaire
- Chargements historiques
- Rejeu
- Gestion des messages en échec
- Supervision des pipelines
- Validation des données
- Reprise sans interrompre le traitement en direct
L’objectif n’est pas de déplacer les données le plus vite possible quoi qu’il arrive, mais de réduire au minimum le temps nécessaire pour qu’un nouvel état correct soit disponible pour le système d’IA.
FAQ
Les systèmes d’IA peuvent-ils vraiment atteindre une latence nulle ?
Aucun système distribué en production n’a une latence littéralement nulle. L’objectif concret est de supprimer les attentes évitables et de réduire le délai de bout en bout jusqu’à ce qu’il soit négligeable pour le cas d’usage. Selon la charge, cela peut signifier des millisecondes, des secondes ou quelques minutes. Une bonne cible doit reposer sur la vitesse à laquelle des informations périmées commencent à influencer les décisions.
Comment le CDC réduit-il la latence des données pour l’IA ?
Le change data capture lit les insertions, mises à jour et suppressions dans les journaux de transactions de la base et envoie ces changements en continu vers l’aval. Il n’est donc plus nécessaire d’attendre des extractions de tables programmées. Pour les applications d’IA qui dépendent de l’état des bases opérationnelles, le CDC peut fortement réduire l’écart entre un changement en production et sa disponibilité dans les systèmes analytiques ou de recherche.
Pourquoi un système RAG peut-il rester périmé avec une base vectorielle rapide ?
La performance des requêtes vectorielles ne détermine que le temps de récupération. Les informations sources peuvent encore traverser plusieurs étapes retardées avant d’atteindre l’index vectoriel : extraction, transformation, découpage, création d’embeddings et mise à jour de l’index peuvent toutes ajouter de la latence. La fraîcheur d’un RAG dépend donc de l’ensemble du pipeline de synchronisation.
Les agents IA ont-ils besoin d’une latence plus faible que les chatbots ?
Souvent, oui. Un chatbot peut donner une réponse dépassée, alors qu’un agent autonome peut effectuer une action erronée à partir d’un état périmé. Les agents lisent aussi souvent une ressource, la modifient puis prennent aussitôt une autre décision. Ces workflows sont plus exigeants en matière d’état actuel, de cohérence et de visibilité des actions tout juste exécutées.
Toutes les données utilisées par l’IA doivent-elles être mises à jour en temps réel ?
Non. L’infrastructure temps réel a le plus de valeur là où des données périmées peuvent changer une décision importante. Statut des transactions, signaux de fraude, stocks, état des comptes et événements opérationnels peuvent nécessiter des mises à jour rapides. Les informations historiques de référence ou une documentation assez stable tolèrent souvent une synchronisation plus lente. Appliquer la même cible de latence à toutes les données crée une complexité inutile.

Sapna Ghodasara est la fondatrice de Guide of AI Tool, où elle rédige des tests approfondis d’outils IA pour les marketeurs, les créateurs et les entreprises. Ses tests se concentrent sur ce qui compte avant de payer pour un outil : cas d’usage réels, avantages et inconvénients sans détour, tarifs et intégration dans le travail quotidien.
Sapna est cofondatrice de SEOMagicLab. Cette double expérience, formation technique et pratique quotidienne du marketing, lui permet de juger les outils IA sous deux angles : la performance réelle de la technologie et la valeur concrète qu’elle apporte à ses utilisateurs.